


Forskningsprojekt Språkbanken
Språkbanken är ett nationellt konsortium som utvecklar och tillgängliggör infrastruktur för forskning som utnyttjar språkliga data (tal, tecken, text).
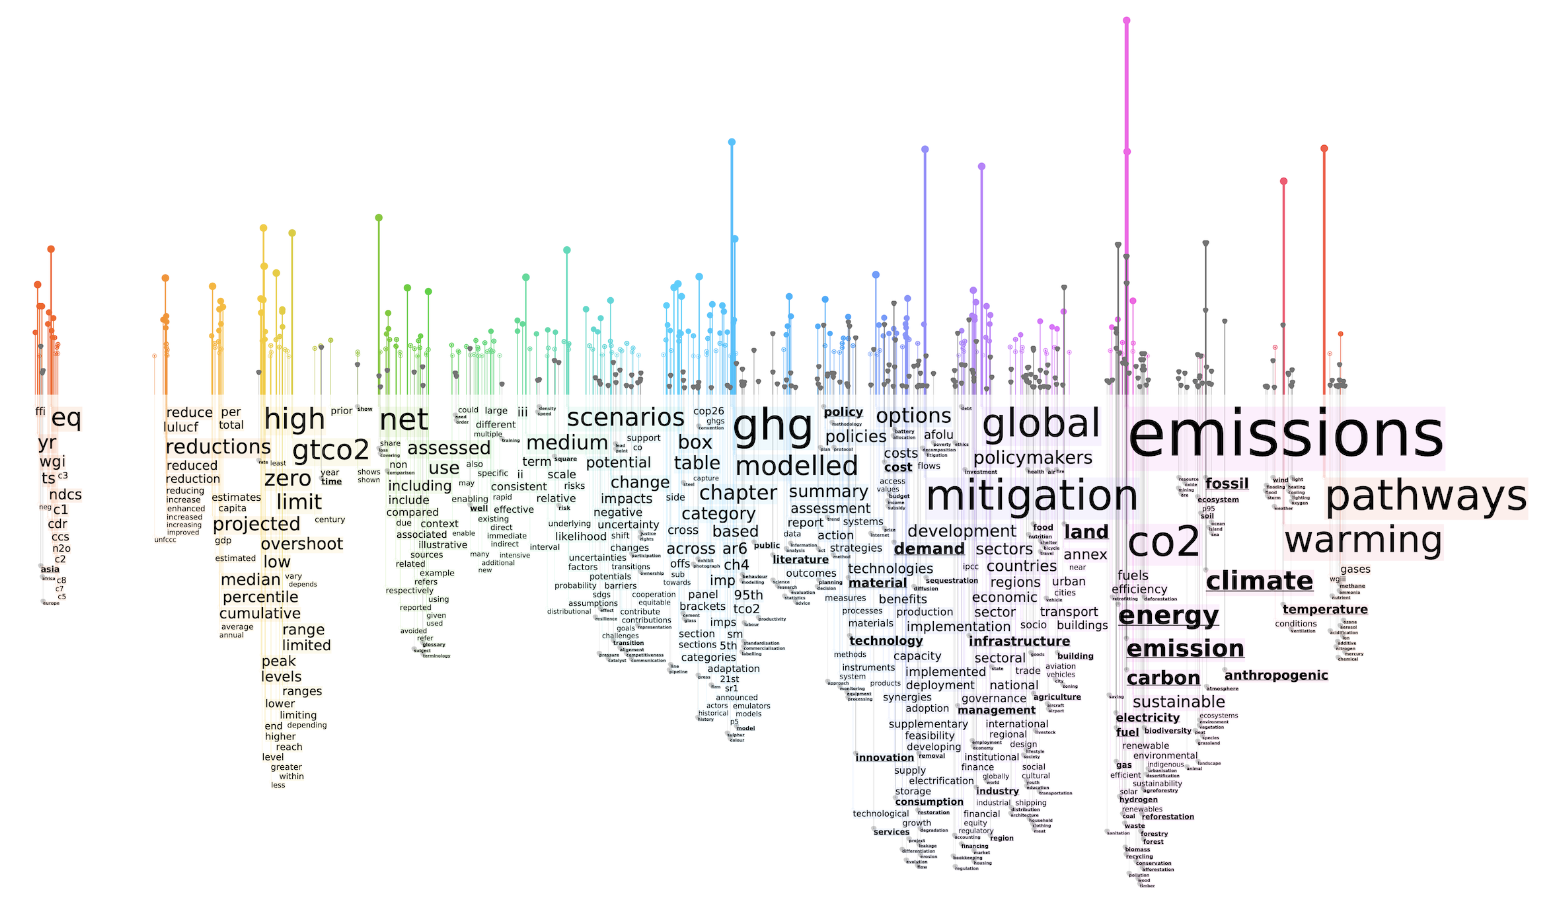
Illustration: wordrain.org
Infrastruktur är verktyg och datamängder som finns färdiga och öppet tillgängliga så att forskaren får mer tid för forskning. Stockholms universitet ingår i Språkbanken genom avdelningarna Datorlingvistik och Teckenspråk vid Institutionen för lingvistik.
Konsortiet startade 2014 och finansieras gemensamt av Vetenskapsrådet och de tio deltagande lärosätena och minnesinstitutionerna. Språkbanken ingår i EU-konsortiet CLARIN som erbjuder forskningsinfrastruktur för språkliga data på europeisk nivå.
Verksamheten i Datorlingvistik kretsar kring utveckling av forskningsinfrastruktur för textdata, främst på svenska och för flerspråkiga parallella texter:
- Verktyg för morfosyntaktisk analys av svensk text.
- Verktyg för länkning och bearbetning av parallella texter.
- Verktyg för visualisering av textmängder, genom till exempel ordregn.
- Datamängder och verktyg för utveckling och utvärdering av dels stora språkmodeller, dels grammatikrättningssystem.
- Datamängder för forskning inom skrivutveckling, skrivstöd respektive språktypologi.
Verksamheten i Teckenspråk kretsar kring utveckling av resurser som används av såväl forskare som i undervisning och av allmänheten:
ORGANISATION:
Datorlingvistik: Robert Östling, Beáta Megyesi, Moa Gärdenfors och Maria Skeppstedt
Teckenspråk: Krister Schönström, Mats Wirén, Dag Lindeberg, Nikolaus Riemer Kankkonen och Josefin Bark
(Se kontaktuppgifter nedan.)