


DNA från marina mikrober kan förutsäga havets tillstånd
Vilka mikroorganismer som finns i en liter havsvatten kan säga mycket om hur havet mår. I en ny metodstudie visar forskare hur DNA-sekvensering och AI kan användas för att förutsäga havets biologiska och kemiska egenskaper.
Foto: John Samuel, CC BY-SA 4.0 och Michaela Lundell. Bilden är ett montage.
– Jag blev överraskad att det fungerade så pass bra! säger Emma Bell, ledare för forskningsgruppen Molecular SeaLab vid Östersjöcentrum, och en av tre förstaförfattare till den nya studien.
I marina forskarkretsar har det en tid talats om potentialen i att kunna ”läsa havet baklänges” med hjälp av den revolutionerande genteknik som gjort det möjligt att upptäcka och identifiera havets allra minsta invånare. Det finns många arter av mikroorganismer, och alla har specifika preferenser vad gäller till exempel salthalt, temperatur, pH, näringstillgång och närvaron av andra plankton. Så om man lär sig mönstret, det vill säga vilken artsammansättning som speglar vilken miljö – eller ännu hellre låter en AI lära sig, som ju snabbt kan hantera enorma mängder data – borde man kunna förutsäga vattnets kemiska och biologiska egenskaper om man vet vilka mikroorganismer som lever där.
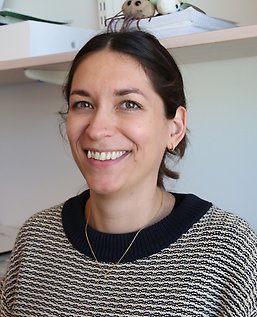
Miljömikrobiologen Emma Bell, ledare för forskargruppen Molecular SeaLab vid Östersjöcentrum. Foto: Michaela Lundell
Eftersom det blivit förhållandevis lätt och billigt att DNA-sekvensera hela miljöprover, som några deciliter havsvatten, har detta betraktats som en lovande, ny metod för modern miljöövervakning.
Nu har forskarna från Stockholms universitet, KTH/SciLifeLab och SMHI med sin noggranna metodstudie visat att det faktiskt fungerar och hur man gör det bäst.
– Målet med vår studie är att kunna ge praktiska råd om hur man kan bygga AI-modellerna för att kunna förutsäga miljöparametrar i havsvattnet från miljö-DNA, säger Karin Garefelt, doktorand vid Miljögenomikgruppen vid SciLifeLab och en annan av studiens förstaförfattare.
Tre olika AI-modeller tränades
Forskargruppen prövade tre olika AI-modeller, en enklare som kallas Random Forest och två mer komplexa. Modellerna tränades på data från nära 400 havsvattenprover, som mellan 2015 och 2020 samlats in i olika delar av Östersjön, Kattegatt och Skagerrak.
Mikrobproverna består vart och ett av någon halvliter havsvatten, som analyserats med så kallad metastreckkodning, för att ta reda på vilka mikroorganismer man har i provet. AI-modellerna fick sedan jämföra mikrobsamhället med värdena på de miljöparametrar, som mätts upp på samma ställen.
Så tränar man AI-modellen
Den tillgängliga datan delas upp i ”träningsdata” och ”testdata”.
Träningsdatan består av både genomik-data (vilka DNA-varianter som finns, och i vilka mängder) och de faktiska uppmätta miljöparametrarna (som salthalt, temperatur, näringsämnena kväve och fosfor i olika former, mängden klorofyll m.m., samt olika växt- och djurplankton som identifierats med mikroskopi), det vill säga ”facit”. AI:n får jämföra och leta efter statistiska mönster.
Sedan får AI-modellen testdata, där den bara får se genomikdatan, och inte de uppmätta miljöparametrarna, och man ber modellen gissa: ”Baserat på vad du lärt dig, vad tror du temperaturen/nitrathalten/siktdjupet etc. är i det här provet?”
Sedan jämför man modellens gissningar med de verkliga, uppmätta värdena. Ju närmare verkligheten modellen gissar, desto träffsäkrare anses modellen vara.
Hög träffsäkerhet – men inte för klorofyll
Alla tre modellerna kunde förutsäga flera parametrar mycket väl, som silikat-, fosfat- och humushalt. Allra bäst var de på att korrekt förutsäga salthalt, temperatur och alkalinitet (vattnets förmåga att stå emot försurning), medan resultaten var betydligt sämre för nitrat och klorofyll, vilket förbryllar forskarna.
– Vi vet inte varför de presterade så dåligt när det gäller nitrat och klorofyll. Det öppnar nya frågor, som vi behöver undersöka vidare. Vi hade förväntat oss att vi utifrån mikrobsamhället skulle kunna förutsäga de parametrarna rätt väl, men uppenbarligen är det inte så enkelt, säger Emma Bell.
När det gäller klorofyll kan det ha att göra med fluorescensen hos klorofyllet, som är det man faktiskt mäter, resonerar forskarna. Fluorescensen varierar beroende på om det är soligt eller molnigt, mycket snabbare än den takt i vilken sammansättningen av mikrobsamhället förändras, vilket är dagar och veckor. Men det är bara en av flera möjliga förklaringar.
Enklaste modellen bäst
Testerna av modellerna visade att den enklare, och lite äldre AI-modellen Random Forest gissade med nästan lika hög precision som den mest träffsäkra av de två mer komplexa modellerna. Eftersom den enklare modellen Random Forest var betydligt snabbare (den behövde 14 sekunders beräkningstid per parameter mot 1–1,5 timme för den bästa tyngre modellen) och dessutom inte kräver lika mycket minne, är det den modell som forskarna förespråkar.
– Random Forest är byggd så att många mindre så kallade beslutsträd tillsammans kommer fram till ett beslut. Man kan köra den på en helt vanlig laptop, till skillnad från de mer komplexa modellerna som bygger på tyngre beräkningsmetoder och kräver tillgång till en betydligt kraftfullare dator. Eftersom det är förknippat med en del utsläpp att träna maskininlärningsmodeller, så är det både mer praktiskt och miljövänligt att använda en lättare modell, säger Karin Garefelt.
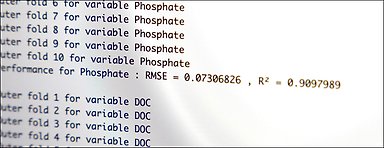
Skärmdump från en av modellerna
Datorn tränar AI-modellen XGBoost på DNA-data från Östersjön. Varje rad är en del av en så kallad korsvalidering – en av flera valideringsmetoder som forskarna i studien använt för att testa AI-modellernas träffsäkerhet.
I det här utsnittet tränas och testas modellen på att förutsäga halten fosfat i vattnet utifrån vilka bakterier och andra mikroorganismer som finns i ett vattenprov. Resultatet anges som ett R²-värde, i det här fallet 0,9097989, vilket innebär att modellen kan förklara ungefär 91 procent av variationen i fosfathalten i vattnet utifrån DNA-data. Datorn går därefter vidare för att träna och testa modellen för DOC (löst organiskt kol).
Kan förutsäga växt- och djurplankton
Något som överraskade henne var modellernas goda förmåga att också förutsäga vilka växt- och djurplankton som finns i vattnet. Det undersöks traditionellt genom mikroskopering och kräver att man samlar in stora mängder vatten genom slangprovtagning (för växtplankton) och vertikal håvning (för djurplankton).
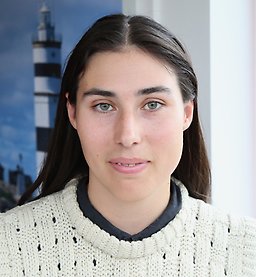
Karin Garefelt, doktorand vid Miljögenomikgruppen på KTH/SciLifeLab. Foto: Michaela Lundell
AI-modellerna däremot behövde mindre än en liter vatten med DNA-sekvenserat mikrobsamhälle för att träffsäkert kunna förutsäga vilka växt- och djurplankton som fanns i havet vid samma plats och tid.
– Utifrån vilka bakterier som finns i provet förstår modellen vilken årstid det är, var i landet provet är taget och vilka näringsförhållandena är. Då kan den sedan dra slutsatser om vilka växt- och djurplankton som förmodligen befinner sig där, förklarar Karin Garefelt.
Enkel provtagning
Det finns klara vinster med att använda genomikdata och AI-modeller i miljöövervakningen. Det är på flera sätt lättare och billigare än traditionell miljöövervakning. Och man kan få ut mer information, inte minst om alla de viktiga men förbisedda bakterierna, som driver många av havets biogeokemiska kretslopp, men i mikroskop bara ser ut som små svarta prickar.
Men det finns också information man går miste om jämfört med mikroskopering, till exempel att kunna se vilka livsstadier planktonen befinner sig i, hur stora cellerna är och om de bildar kolonier.
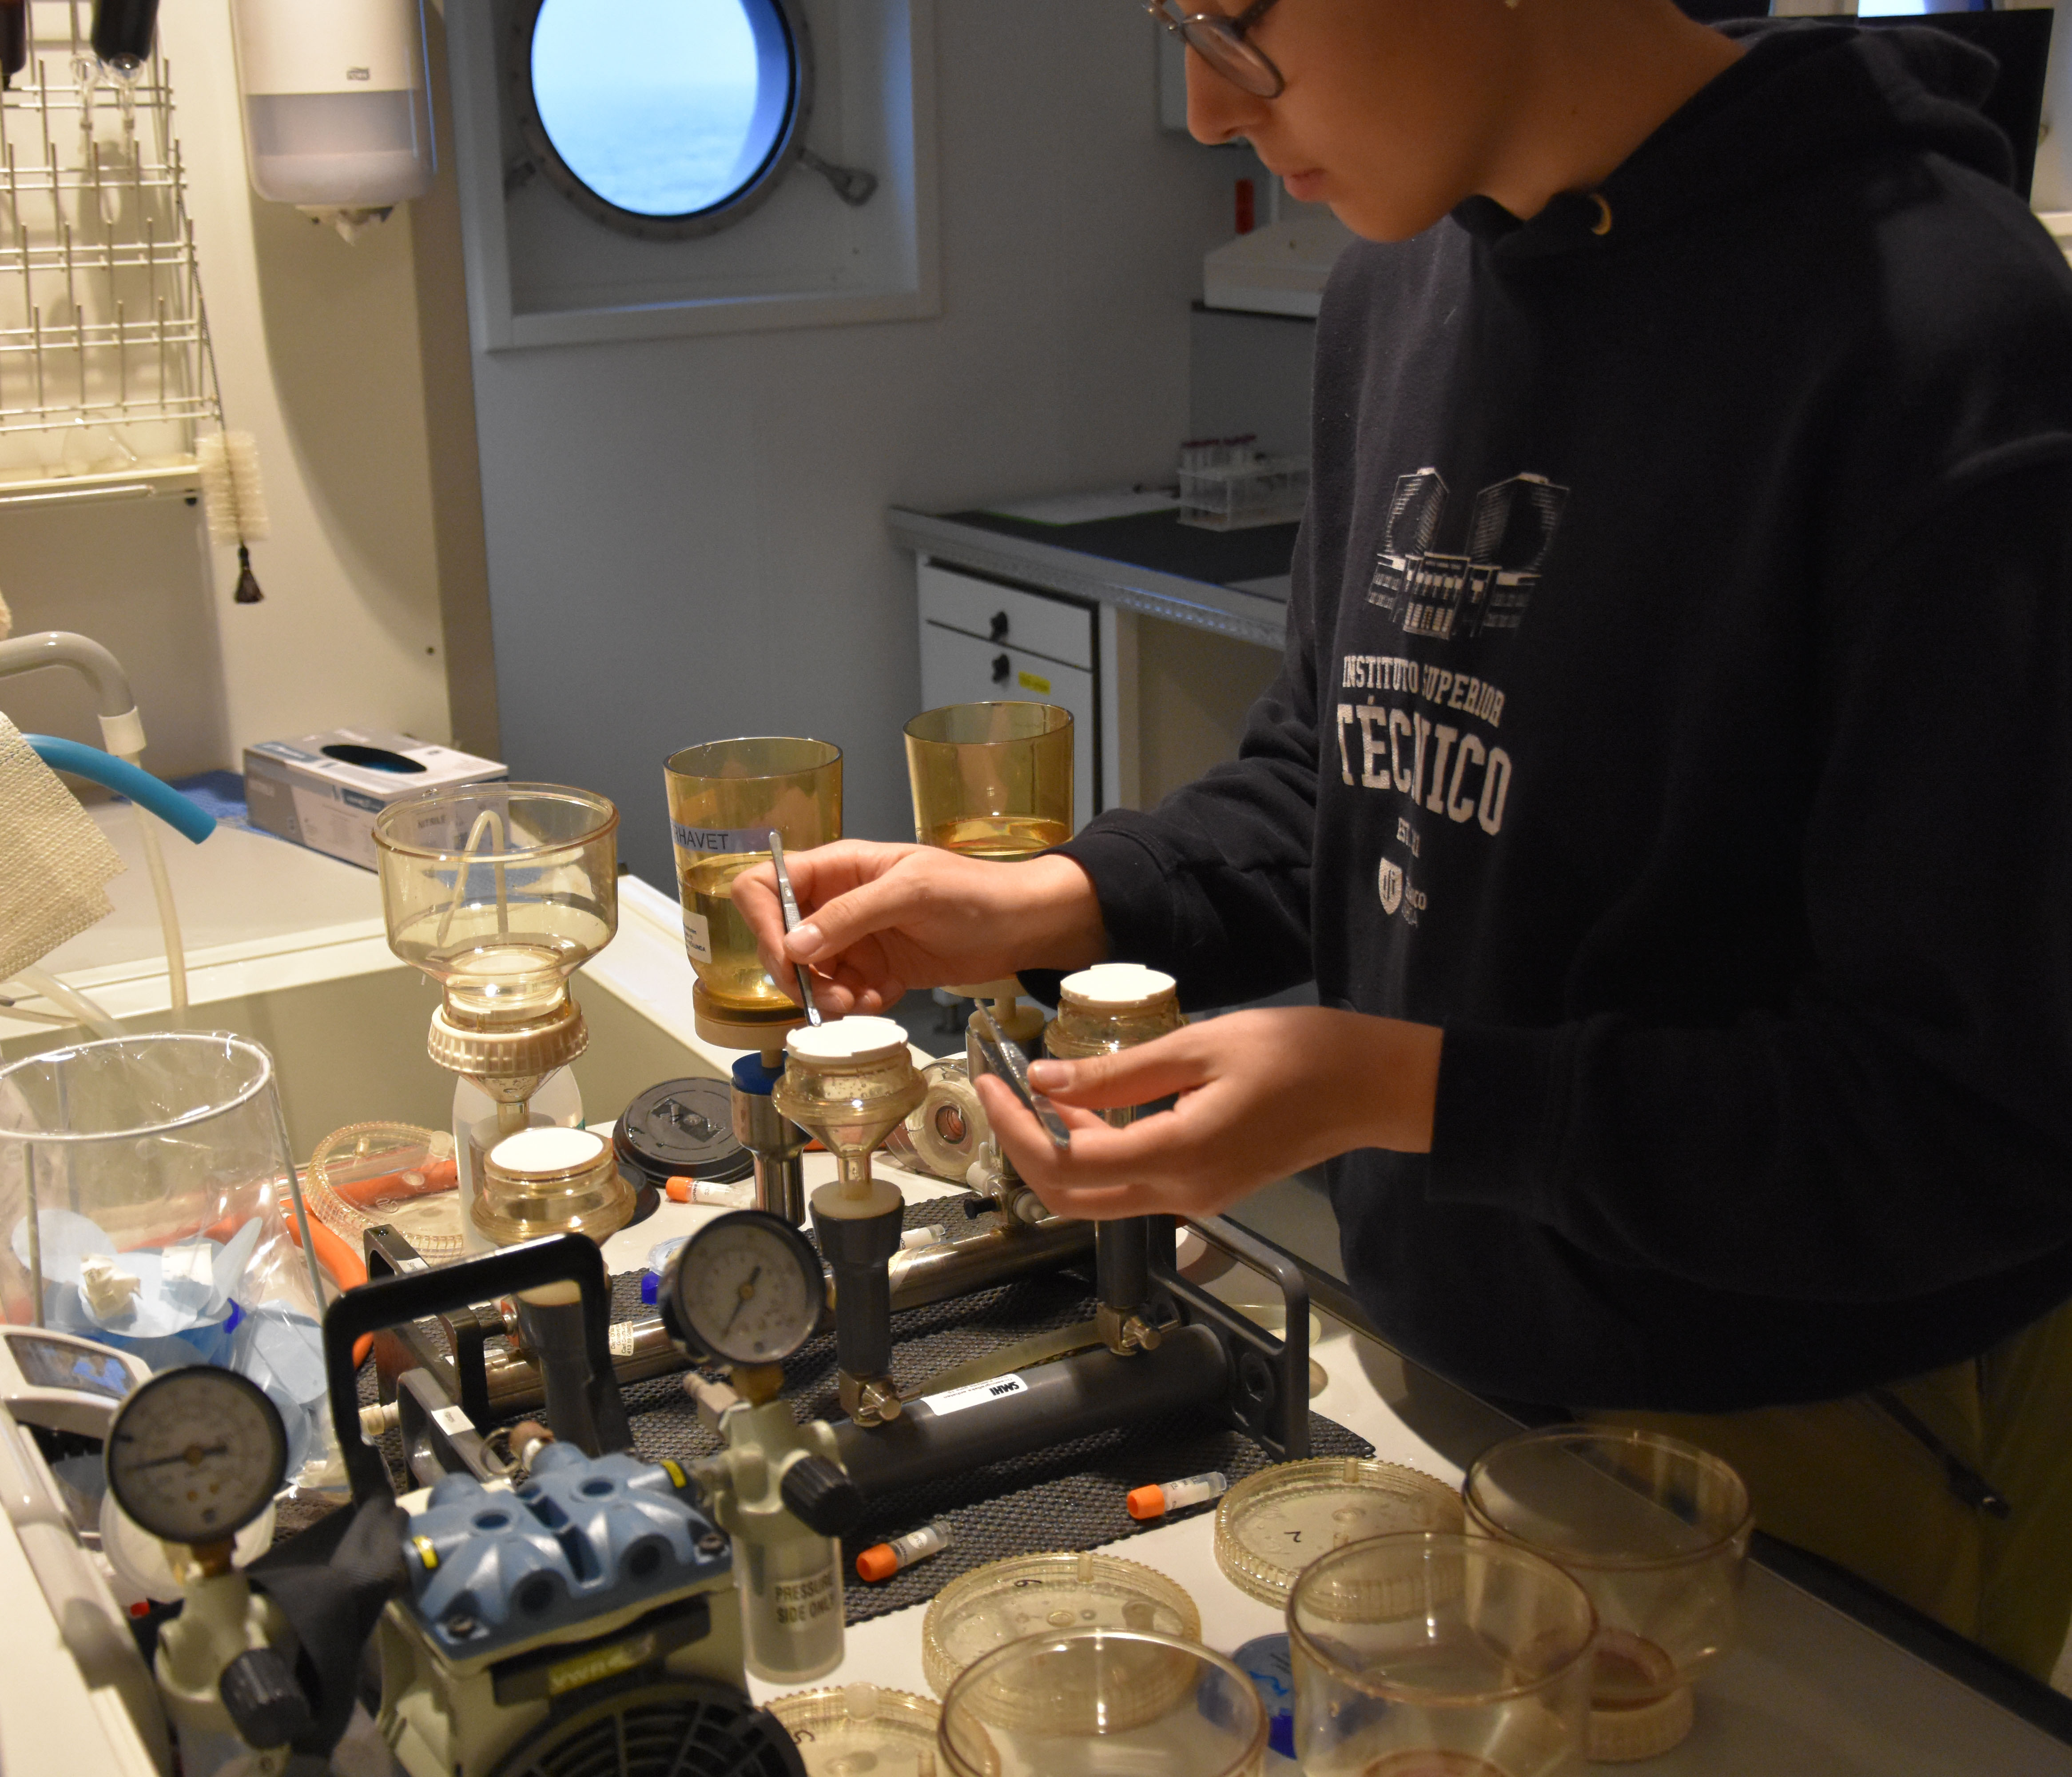
Karin Garefelt filtrerar havsvattenprover för DNA-analys av mikrobsamhället, ombord på forskningsfartyget Svea. Foto: Mikael Hedblom/SMHI.
MetaSTRECKkodning
Metastreckkodning (på engelska metabarcoding) är en metod för att identifiera vilka arter som förekommer på en viss plats. Det innebär att man extraherar DNA och letar efter en kort, specifik del av en gen (”markör”), som kan användas för att skilja olika organismer åt.
I den aktuella studien användes två DNA-markörer: en för prokaryoter, som bakterier (16S rRNA) och en för encelliga eukaryoter, som alger och protozoer (18S rRNA).
DNA-markörerna kopieras med hjälp av PCR-teknik upp i så stor mängd (”amplifieras”) att de går att sekvensera, det vill säga analysera baspar för baspar. Sekvenserna jämförs sedan med referensdatabaser för att ta reda på vilka organismer man har i provet. Man kan också se i vilka relativa mängder organismerna förekommer.
Komplement i miljöövervakningen
Forskarna bakom studien betonar att den metod de testat och förespråkar är ett komplement till den pågående marina miljöövervakningen, och alls inte kan ersätta den. Att det alls går att göra tillförlitliga AI-modeller bygger på att det finns stora mängder tillgängliga miljöövervakningsdata.
– Det finns långa tidsserier av miljödata som inte får brytas, och miljön förändras ständigt. Man behöver kontinuerligt validera modellerna, och för det behövs faktiska mätningar. Ju mer data man har, desto bättre modeller kan man utveckla, säger Emma Bell.
Förutom att fylla i luckor, där mätvärden från miljöövervakningen av olika anledningar saknas, kan metoden utvecklas till att förutsäga även annat i miljön, som till exempel miljögifter, plastföroreningar och växthusgaser, spår forskarna.
– I teorin räcker det att ta ett litet prov på mikroberna, så kan det berätta för oss hur resten av miljön där är, säger Emma Bell.
Nästa spännande användningsområde är att kunna avgöra vilka mikrober som gör vad i vattnet, och hur de gör det. Vilka driver till exempel uppkomsten av algblomningar?
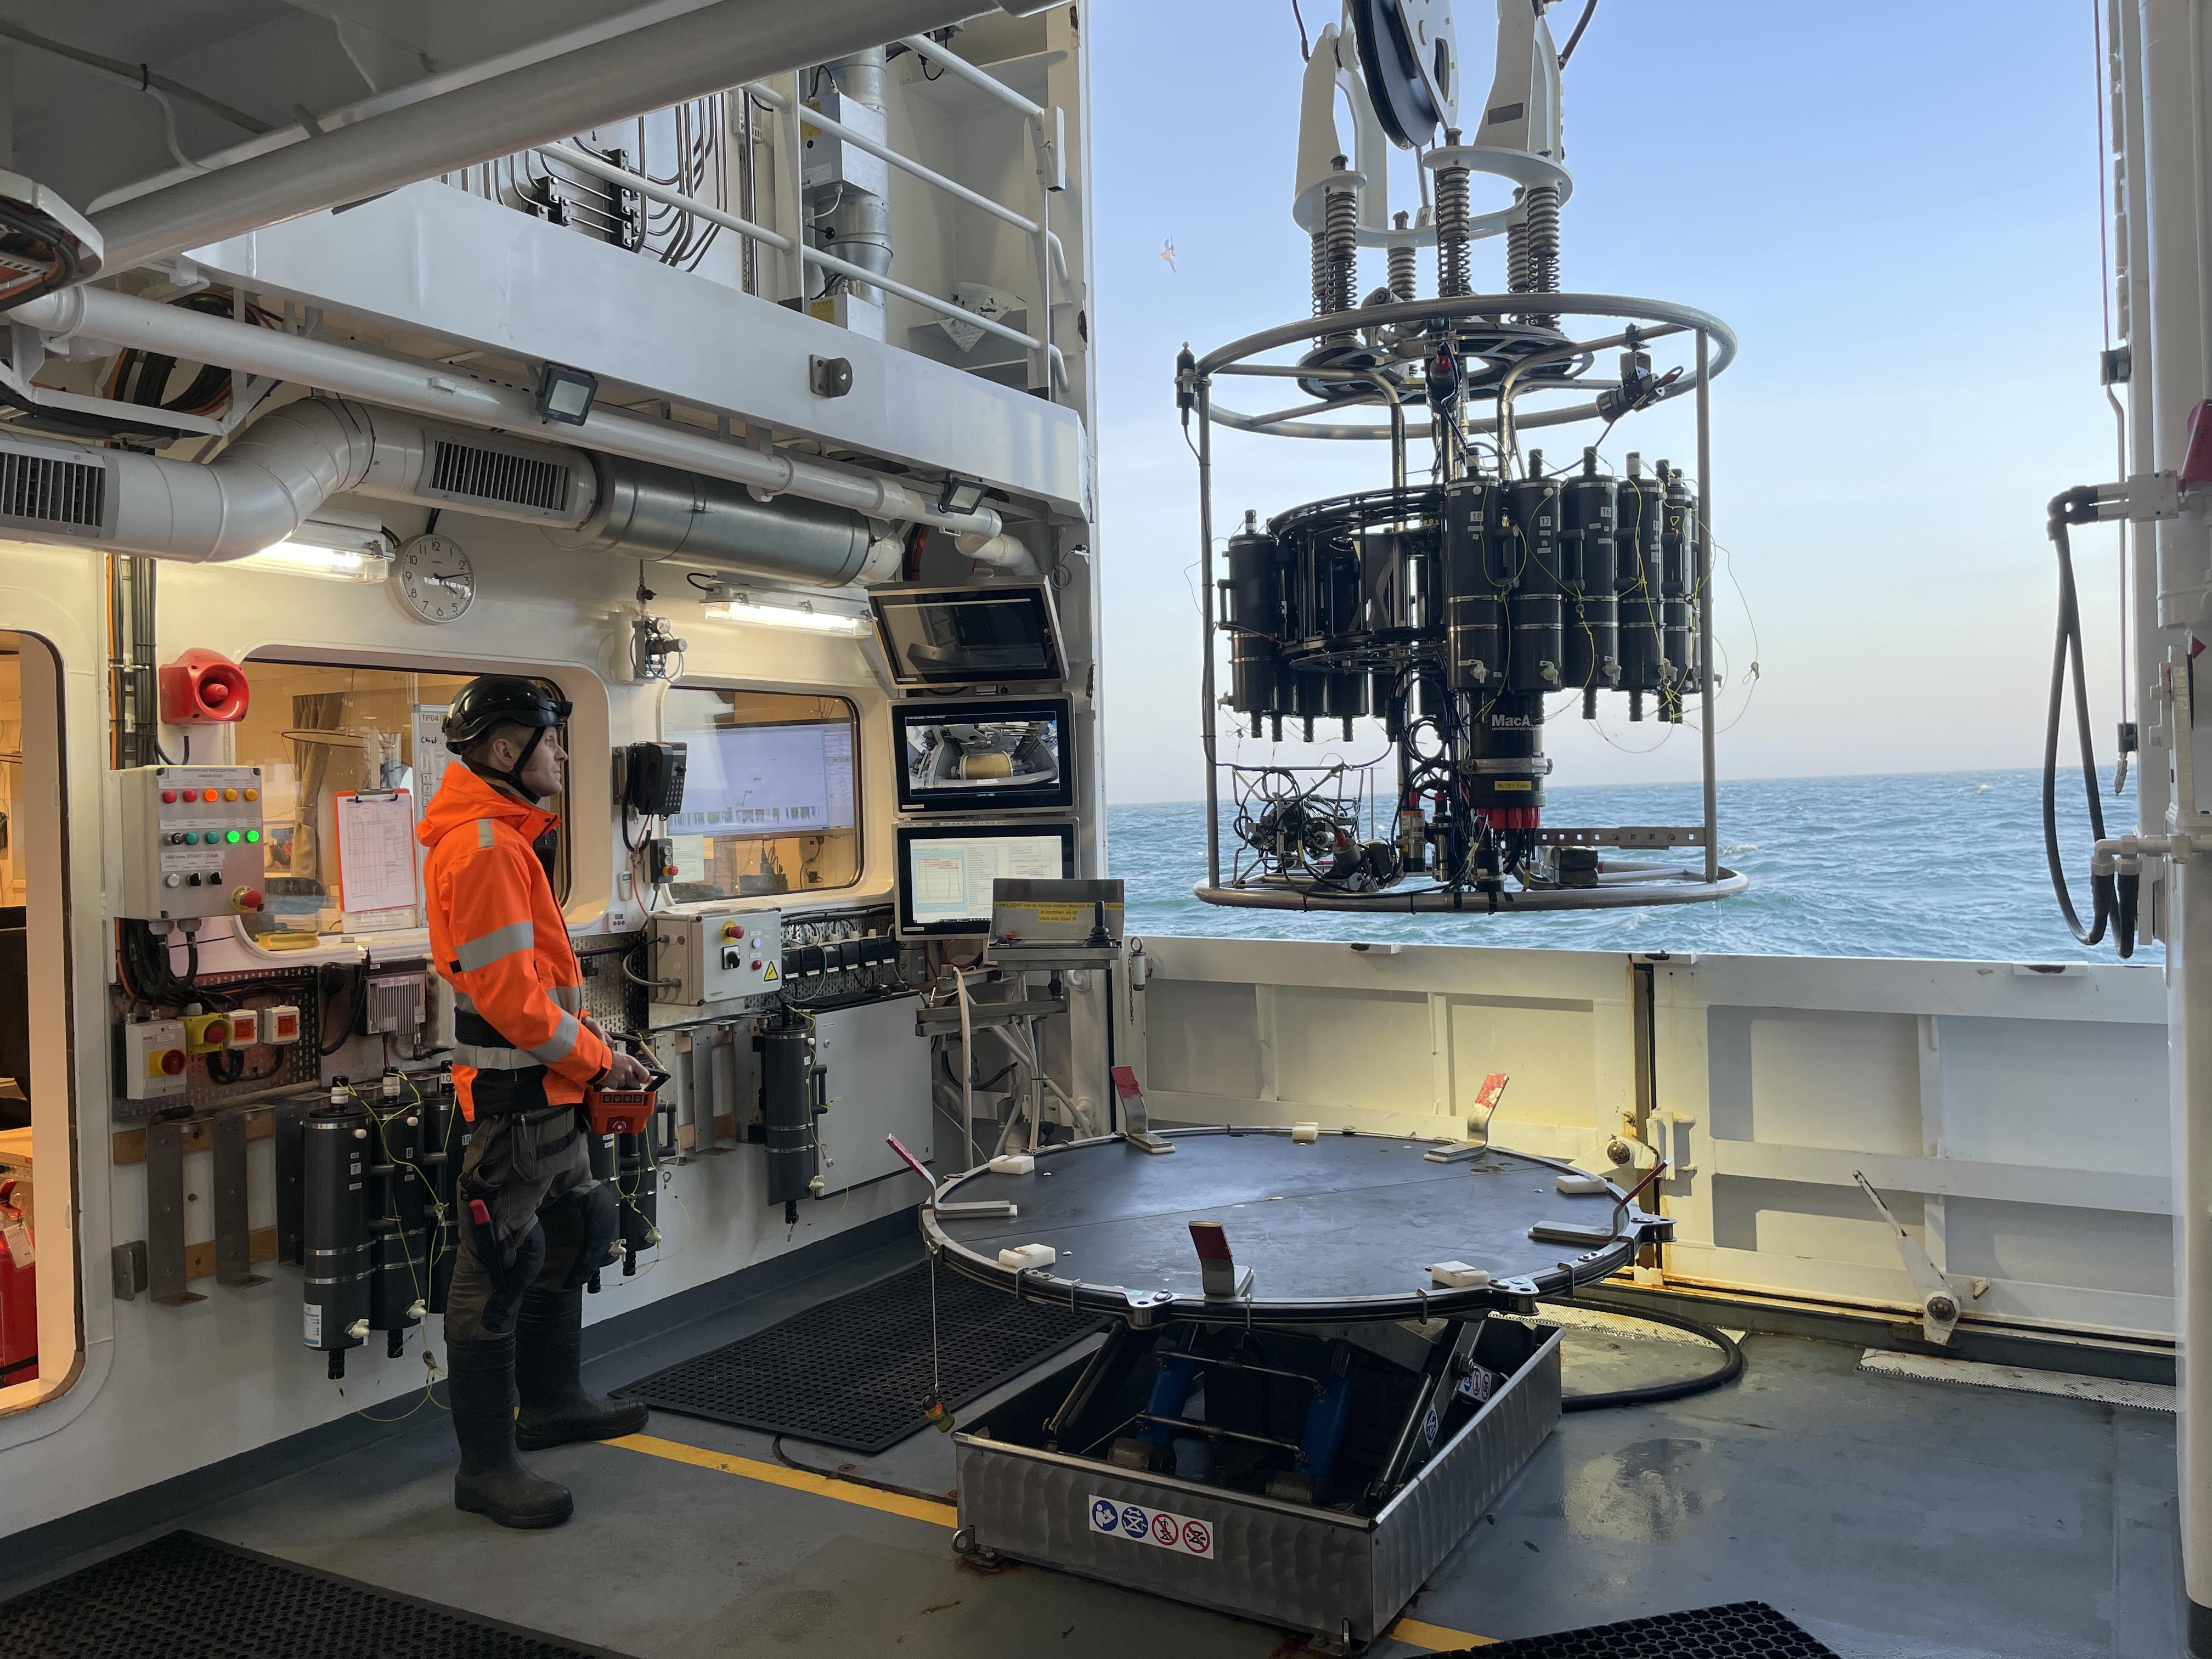
Marin miljöövervakning av det öppna havet (”pelagialen”) med forskningsfartyget Svea, varifrån datan till metodustudien hämtats. Instrumentet i bilden är en så kallad rosetthämtare, med vilken man kan ta vattenprover från olika djup. Foto: Johanna Kozak/SLU.
Bör införlivas i miljöövervakningen
Idag ingår inte provtagning av mikroorganismer i den standardiserade marina miljöövervakningen. Det är något som forskarna hoppas ska förändras.
– Att samla in de små proverna man behöver för DNA-analys är relativt enkelt, och de kan förvaras i frysen i flera år, säger Emma Bell.
– Mikroberna bör verkligen inkluderas i miljöövervakningen, fortsätter hon. Teknikutvecklingen går snabbt och man vet aldrig vad proverna kommer att kunna säga oss. Fortsätt med miljöövervakningen och inkludera mikrober, det finns så mycket information att hämta från dem!
Data från den marina miljöövervakningen
Metodstudien bygger på miljödata från den nationella marina pelagialövervakningen, som inkluderar biologiska, fysikaliska och kemiska egenskaper hos havsvatten, och finns fritt tillgängliga i databasen SHARK.
Från SHARK är också mikroskopibaserade räkningar av växt- och djurplankton hämtade.
Även genomikdatan – DNA-sekvenserna från havets mikroorganismer – kommer från vattenprover tagna inom den nationella marina pelagialövervakningen. Proverna har analyserats med så kallad metastreckkodning i två tidigare studier, och resultaten finns fritt tillgängliga i databasen European Nucleotide Archive.
Text: Michaela Lundell
Den vetenskapliga artikeln kan läsas här:
Författare är Emma Bell, Karin Garefelt, Krzysztof T. Jurdzinski, Luis F. Delgado, Fanny Lindrooth, Bengt Karlson och Anders F. Andersson.
Läs mer om mikroorganismernas betydelse för havets biogeokemiska kretslopp:
Havets osynliga invånare – okända mikrober med stor påverkan
Senast uppdaterad: 2026-09-30
Sidansvarig: Stockholms universitets Östersjöcentrum