


Etniska stereotyper under lupp i nytt forskningsprojekt
Vad består etniska stereotyper i Sverige av och vad har de för betydelse? Det ska ett nytt projekt i sociologi undersöka. Forskarna ska analysera texter från sociala medier och bloggar från internets början till idag.
Projektet, under ledning av Magnus Bygren, ska fokusera på stabilitet och förändring av stereotyper associerade med olika grupper av utrikesfödda. Forskarna ska dessutom titta på om och hur stereotyperna samspelar med egenskaper som gruppens storlek, ursprungsregion, genomsnittlig utbildningsnivå och könssammansättning.
Forskarna ska använda texter från olika digitala plattformar i textdatabasen Korp, utvecklad i den nationella forskningsinfrastrukturen Språkbanken. Korps textdatabas för sociala medier och bloggar är storskalig och omfattar över 100 miljarder ord från perioden 1998-2024.
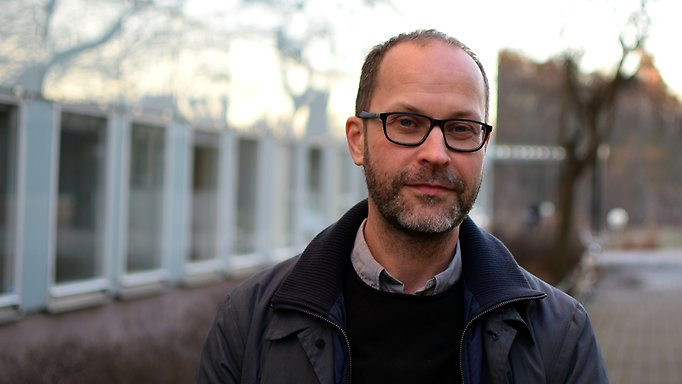
Magnus Bygren.
För att analysera hur stereotyper manifesterar sig online ska forskarna använda kvantitativ analys som är baserad på maskininlärning. De ska undersöka hur vissa substantiv, adjektiv och verb är associerade med olika grupper, och hur orden korrelerar med gruppegenskaper hämtade från registerdata.
Den kvantitativa analysen ska kombineras med en kvalitativ djupläsning av ett urval av de undersökta texterna, med fokus på tillfällen då innehåll, betydelse och meningssammanhang för stereotyperna förändras.
Projektet bidrar på ett fundamentalt plan med kunskap om hur och varför stereotyper förändras över tid i samhällen.
Projektet ”Etniska stereotyper i Sverige under 2000-talet” är finansierat av Riksbankens Jubileumsfond och leds av Magnus Bygren, professor i sociologi vid Stockholms universitet. Övriga deltagare i projektet är Moa Bursell och Melis Kirgil.
Senast uppdaterad: 2025-12-04
Sidansvarig: Sociologiska institutionen