


Nytt verktyg avslöjar hur AI konstruerar sina svar
Alla vet att chattbotar hallucinerar. Och vi vet också att AI kan plocka information från oseriösa webbplatser för att producera sina svar. Nu har DSV-forskare skapat ett verktyg som löser en del av problemen.
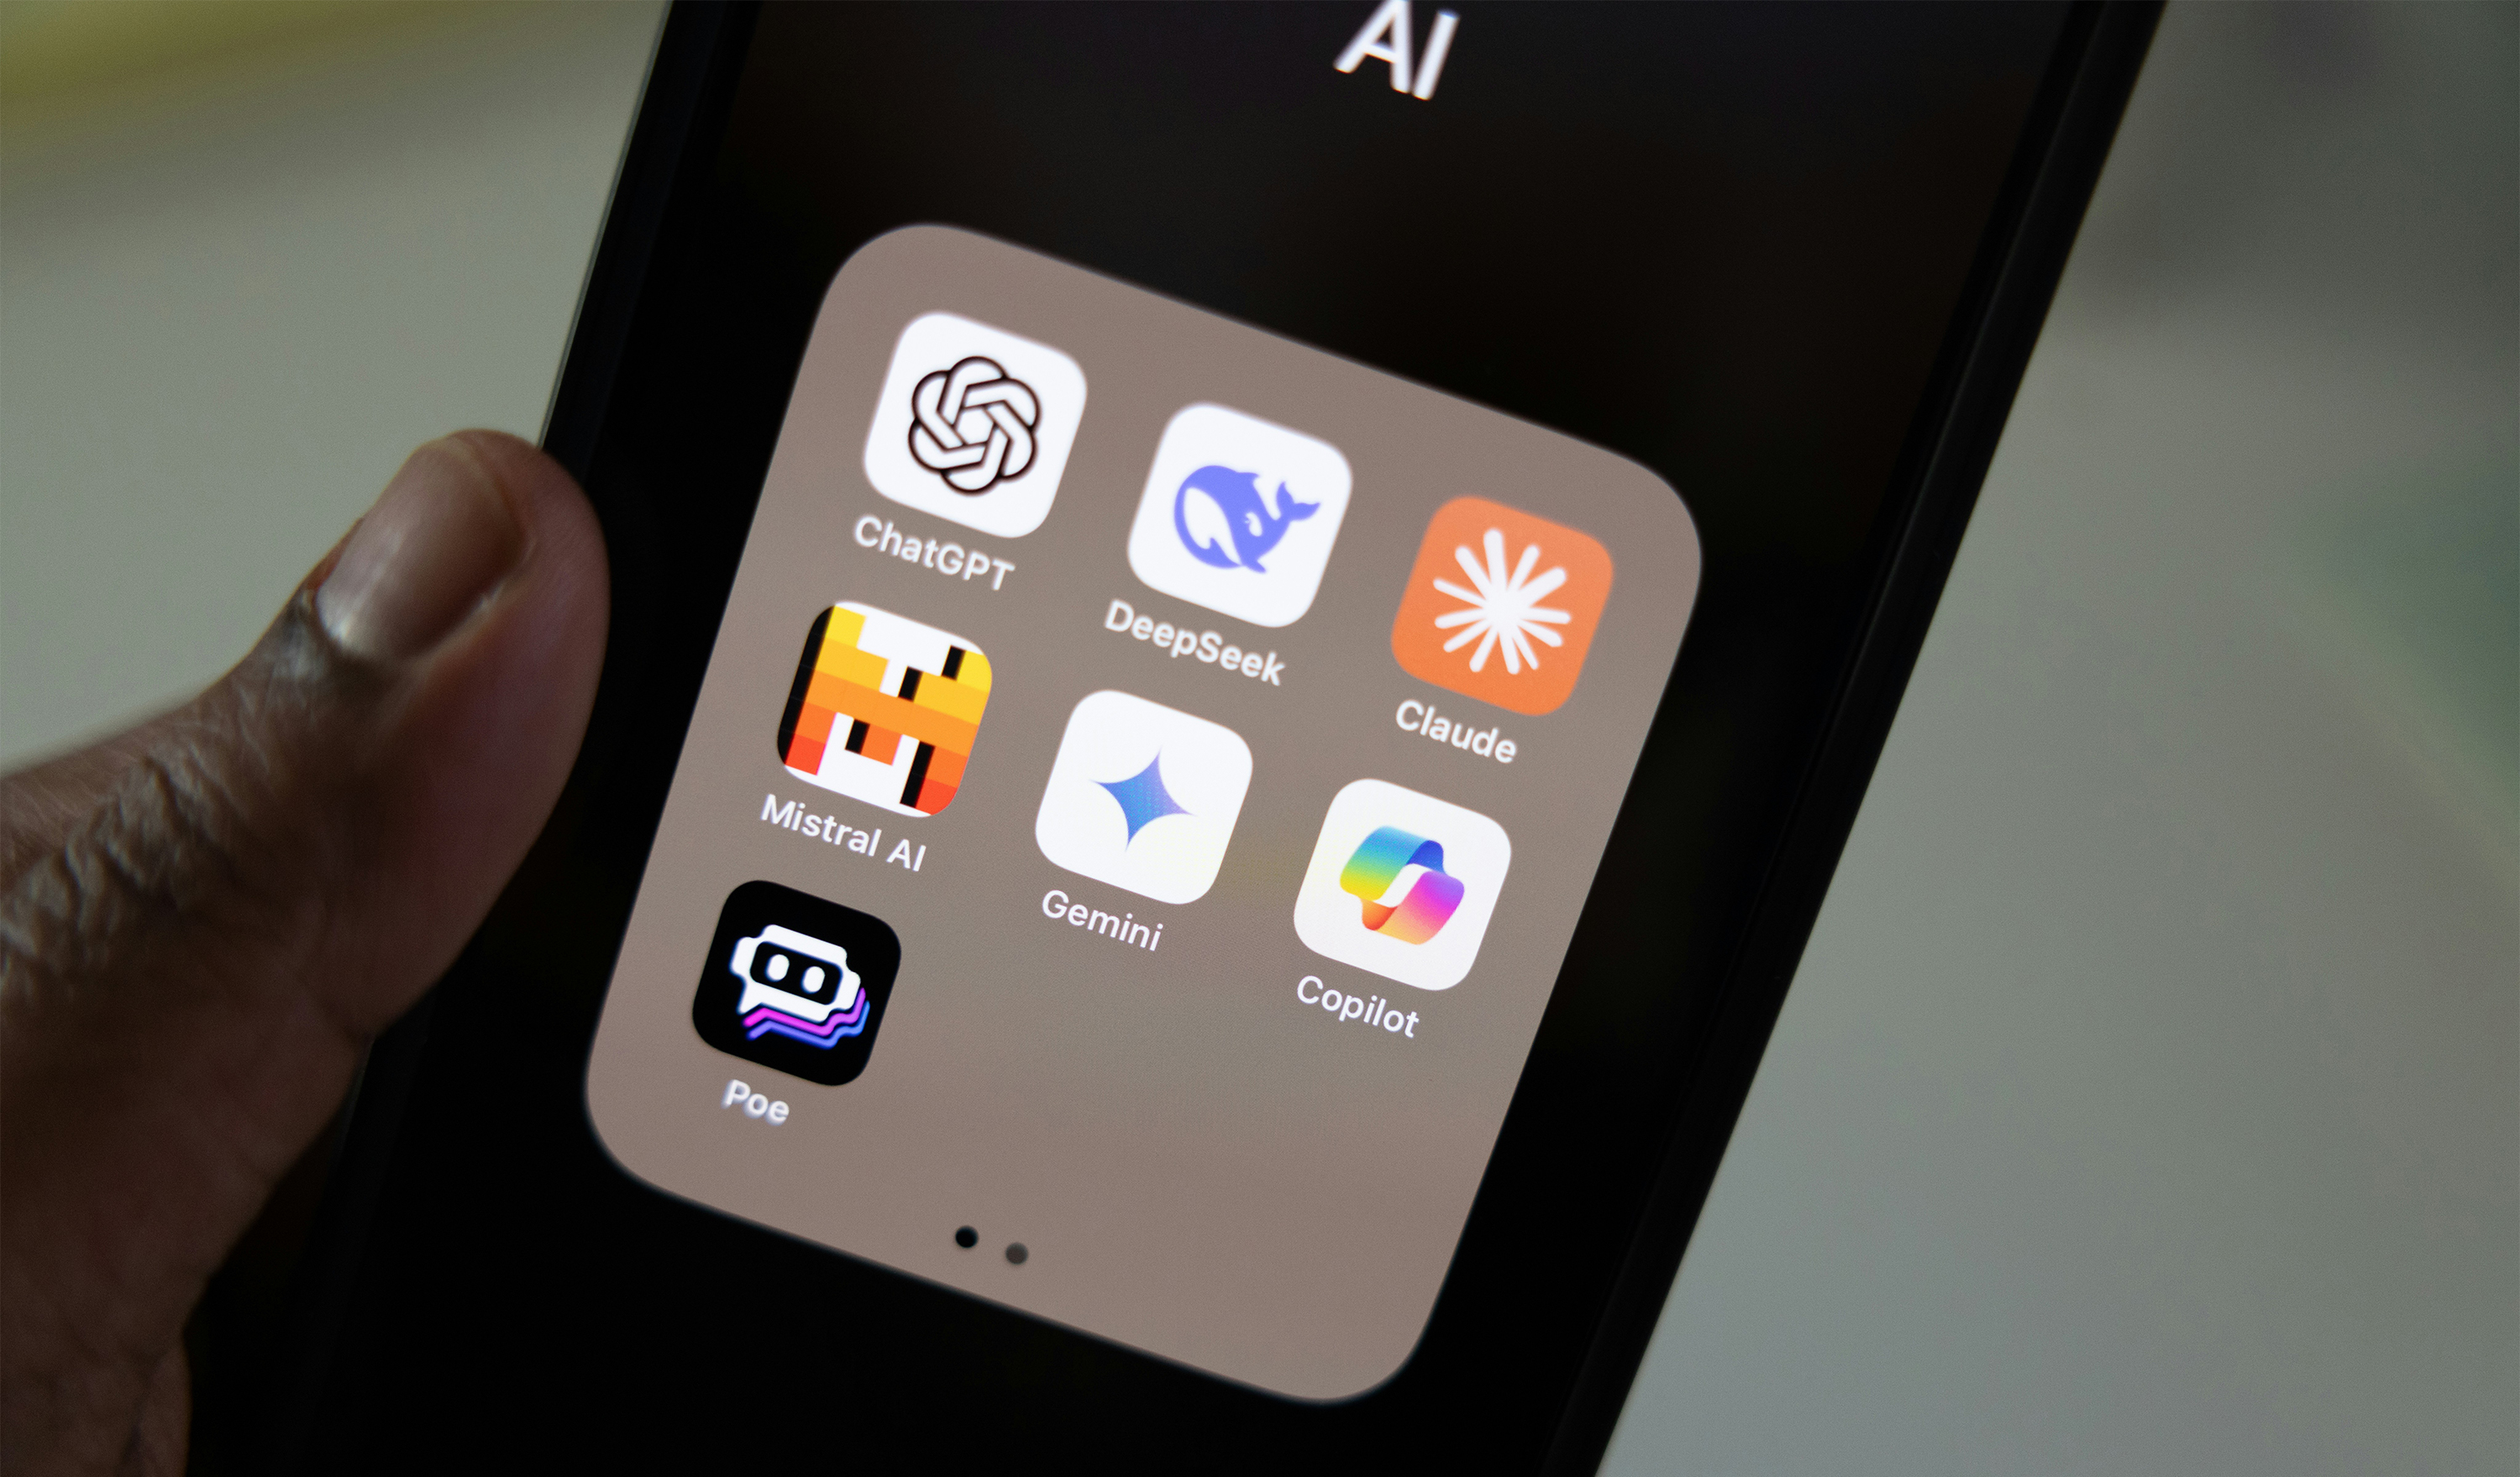
När du ställer en fråga till Chat GPT, Claude, Gemini eller Perplexity får du snabba och självsäkra svar tillbaka. Men hur vet du vilka källor som ligger till grund för svaren?
Korbinian Randl, doktorand på Institutionen för data- och systemvetenskap (DSV), vill förbättra tillförlitligheten hos de stora språkmodeller som chattbotarna bygger på. Språkmodellerna kallas ofta LLM:er, efter engelskans ”large language model”.
– När jag pratar med vänner och bekanta får jag känslan att de nästan ser LLM:er som mänskliga. Det har förstås att göra med hur chattbotarna är utformade – det ska verka som att du pratar med en annan människa. Vi är dessutom vana vid att datorer alltid har rätt. Men AI kan misslyckas, och jag tror att vi behöver metoder för att visa det, säger Korbinian Randl.
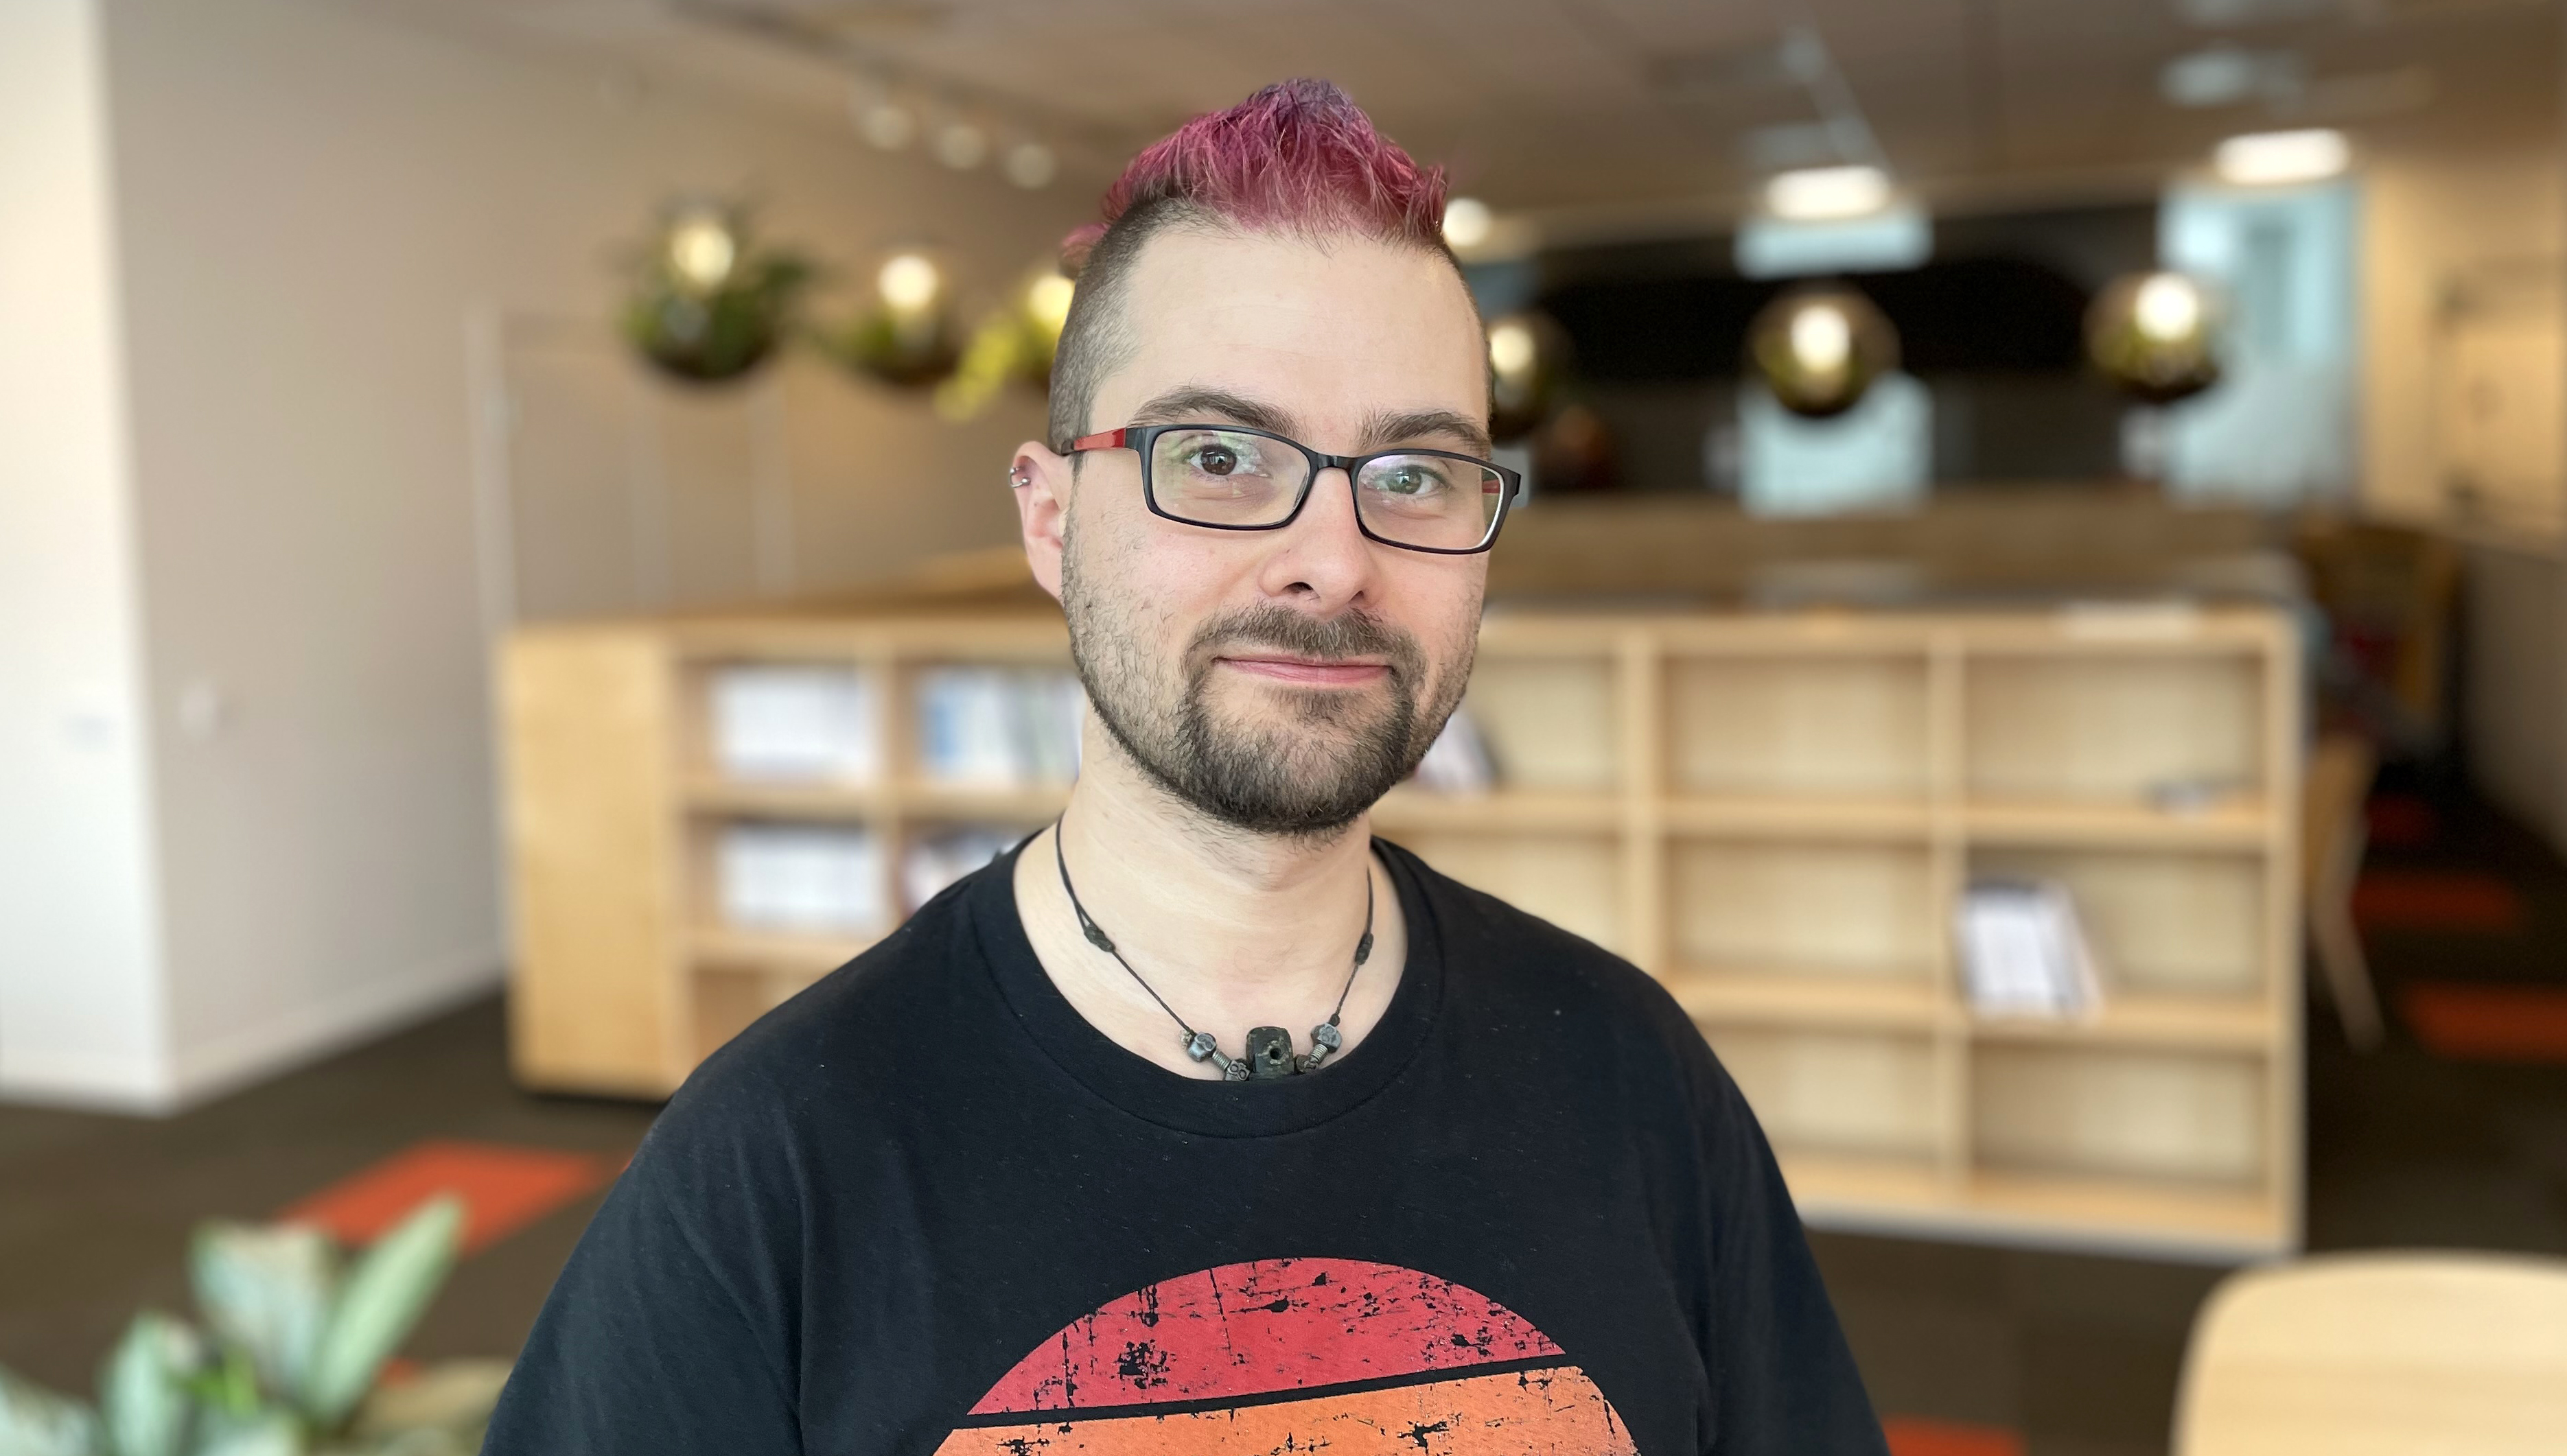
AI-genererade svar måste kunna förklaras om vi ska kunna lita på dem, anser Korbinian Randl.
Två komponenter – retriever och generator – kickar in när du skickar en fråga till din chattbot. Systemet kallas RAG (Retrieval-Augmented Generation). Först söker retrievermodulen igenom webbplatser och andra källor och rangordnar dokument efter relevans. Sedan läser generatormodulen, som är en stor LLM, dokumenten och skriver ett svar.
En vetenskaplig artikel – och ett fungerande verktyg
Kruxet är att båda komponenterna kan misslyckas. Och du vet inte om chattboten använder relevanta källor från de rangordnade dokumenten för att skriva sitt svar, eller om den förlitar sig på Reddit-trådar. Faktum är att det ofta finns ett glapp mellan retrievermodulens rangordning och de källor som generatormodulen sedan använder. Det problemet ville Korbinian Randl och hans forskarkollegor lösa.
– Vi har skapat ett ramverk som visar vilka delar av dokumenten som använts för att generera rangordningen. Det visar också vilka delar av dokumenten som använts för att generera vilka delar av svaret.
– Vi har skrivit en vetenskaplig artikel om det här, men vi har också byggt ett fungerande verktyg, förklarar Randl.
Hans studier visar att generatormoduler ignorerar retrievermodulers högst rankade dokument i upp till 78 procent av fallen. Och när retriever och generator faktiskt är överens, är det upp till fyra gånger mer sannolikt att chattbotens svar blir korrekt.
Modellerna tänker inte
Om du bara frågar Chat GPT om middagsrecept eller en kändis kärleksliv spelar källorna kanske mindre roll. Men om du är läkare och konsulterar ett AI-system för att hjälpa en patient, är det avgörande att högkvalitativa dokument används för att generera det bästa svaret. Transparens, förklarbarhet och tillit är grundläggande i den här processen.
– AI-modeller genererar naturligt språk genom en statistisk process, genom att förutsäga vilket ord som är mest sannolikt att följa på ordet innan. Modellerna tänker inte, och de är inte logiska. Det finns många osäkerheter här, säger Korbinian Randl.
– Det är därför vi måste kunna förklara varje svar så att användaren kan förstå vad modellen fokuserade på internt, fortsätter han.
Randl påpekar också att användare har rätt till en förklaring enligt EU:s dataskyddsförordning (GDPR).
Tar itu med glappet på ett nytt sätt
Han och hans kollegor kallar sitt nya granskningsramverk för RAG-E. Förutom att förklara varför dokument hämtades och hur mycket de påverkade det genererade svaret, kombinerar RAG-E de två variablerna till ett enda värde som kallas WARG.
– Idén om ett glapp mellan vad retrievermodulen listar och vad generatormodulen använder – och att förklara sådana system – är inte ny. Andra forskare har skrivit artiklar om det med fokus på en av komponenterna. Men jag har inte kunnat hitta befintlig litteratur som kombinerar processerna hos retriever och generator. I den bemärkelsen är det här kunskap som är ny för världen.
Utvecklare av AI-modeller kan testa det nya ramverket genom att importera det till sin källkod. De behöver bara ändra två rader kod för att få veta sitt WARG-värde och förklaringen till det.
Modellerna är konstruerade för att alltid producera svar
Men för användare av generativa AI-verktyg som Chat GPT är processen bakom svaret fortfarande dold – än så länge, i alla fall. Så vad kan vi göra för att skydda oss mot hallucinationer och vilseledande svar?
– Mitt tråkiga svar på den frågan är att alltid dubbelkolla. Googla det!
– Överensstämmelsen mellan retrieverns listor och generatorns svar beror på så många saker: Ämnet, modellen du använder, hur du formulerar frågan – och turen spelar också in. Modellerna är konstruerade för att alltid producera svar, och aldrig säga emot dig, konstaterar Korbinian Randl.
Mer om forskningen
Artikeln ”Quantifying Retriever-Generator Alignment in RAG with Local Explanations” har antagits till 2026 Conference on Empirical Methods in Natural Language Processing (EMNLP). Artikeln presenteras i Budapest, Ungern, 24–29 oktober.
Den är skriven av Korbinian Randl (DSV, Stockholms universitet), Guido Rocchietti (TU Berlin), Aron Henriksson (DSV, Stockholms universitet), Ziawasch Abedjan (TU Berlin), Tony Lindgren (DSV, Stockholms universitet) och John Pavlopoulos (Athens University of Economics and Business).
Läs den vetenskapliga artikeln
Läs ett blogginlägg av Korbinian Randl (på engelska)
Korbinian Randl är doktorand på Institutionen för data- och systemvetenskap (DSV), Stockholms universitet.
Kontakta Korbinian
Mer om DSVs forskning och utbildning
Senast uppdaterad: 2026-10-06
Sidansvarig: Institutionen för data- och systemvetenskap